CI/CD и инфраструктура для веб-приложения
Инфраструктура и CI/CD для сайта компании Клиент Компания-производитель фирменных исследовательских продуктов, которой требовался сайт для публикации каталога продукции
Задача Разработчики написали код обычного веб-приложения (backend NestJS + frontend Next.js), но инфраструктура полностью отсутствовала: деплой выполнялся вручную, не было CI/CD, настроенного сервера, мониторинга, бэкапов и разделения тестового и боевого окружений. Требовалось выстроить полный DevOps-стек с нуля: GitLab CI/CD, собственный сервер, два изолированных контура, HTTPS, мониторинг, оповещения и автоматические бэкапы.
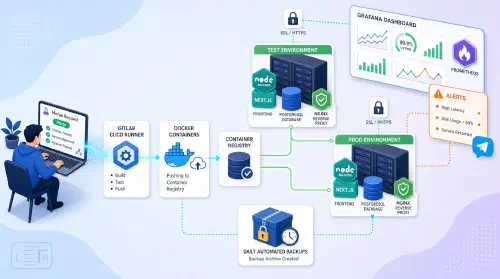
Решение 1. Подготовка сервера и безопасность VPS на Ubuntu 24.04: 4 vCPU, 6 ГБ RAM, 120 ГБ диск SSH только по ключам, отключён root, выделенный деплой-пользователь (sudo + docker) UFW Firewall: открыты только порты 80, 443, 22 и SFTP (2222/2223) Автоматические обновления безопасности (unattended-upgrades) 2. GitLab CI/CD Self-hosted GitLab с групповым Container Registry Пайплайны для backend и frontend: build → push → deploy Привязка веток: test → образ :test → контур test; master → образ :latest → контур prod; теги v* → релизные сборки; dev → только сборка SSH-деплой на сервер через SSH_PRIVATE_KEY, секреты в Protected CI-переменных Инфраструктурный репозиторий server-devops с джобой deploy-all: жёсткий сброс к origin + docker compose up -d --pull always 3. Docker Compose и контуры Три compose-файла: app/ (test), app-prod/ (prod), monitoring/ на общей Docker-сети Сервисы каждого контура: backend NestJS, frontend Next.js, PostgreSQL 16, pgAdmin, SFTP Политика рестарта on-failure:10 для всех контейнеров приложений Все конфиги, дашборды и правила — в git, применяются пайплайном 4. Reverse Proxy и HTTPS Единый reverse proxy nginx-proxy + acme-companion на портах 80/443 Автоматические сертификаты Let’s Encrypt с автопродлением Все точки входа только по HTTPS: основной сайт, тестовый контур, панель управления БД, мониторинг 5. Мониторинг и алерты Prometheus + Grafana с автоматическим провижинингом дашбордов из git (4 дашборда: cAdvisor, Node Exporter, Logs/App, PostgreSQL) Exporters: node, cAdvisor, postgres, nginx (stub_status + access-лог: RPS, 4xx/5xx, время ответа/апстримов), HTTP-пробы blackbox для frontend/backend Alertmanager с интеграцией в Telegram — один бот, отдельные чаты на каждый контур (test / prod) Правила алертов: падение сервисов, высокая нагрузка CPU/RAM/диск (>80%), циклы рестартов, ошибки 5xx backend 6. Логирование и бэкапы Loki + Promtail: логи всех контейнеров собираются и доступны в Grafana (Logs Drilldown) Автоматический скрипт бэкапа: pg_dump БД prod + tar-стрим тома загрузок prod в единый архив Ротация 30 дней, ежедневный cron в 03:00, процедура восстановления проверена и задокументирована Технологии GitLab CI Docker Prometheus Grafana Nginx PostgreSQL Результаты ✅ Деплой: merge в master → автоматическая сборка, публикация и деплой на сервер
✅ Окружения: полное разделение test и prod на одном VPS через общую Docker-сеть
✅ HTTPS: все сервисы только по HTTPS с автоматическими сертификатами Let’s Encrypt
✅ Мониторинг: 4 дашборда, пробы доступности, алерты в Telegram (отдельные чаты на контур)
✅ Бэкапы: ежедневный бэкап БД prod + тома загрузок, ротация 30 дней, восстановление проверено
✅ Безопасность: SSH по ключам, отключён root, UFW, секреты в Protected CI-переменных